
NVIDIA GR00T 2: el robot que aprende mirando videos humanos y acierta el 95% con solo cinco ejemplos
NVIDIA presentó GR00T 2, un modelo de inteligencia artificial que enseña a los robots a hacer tareas con las manos mirando videos de personas, sin que nadie les programe cada movimiento. El anuncio llegó el 9 de noviembre en la Conferencia sobre Aprendizaje de Robots (CoRL), en Austin, Texas. Es lo que NVIDIA llama un modelo de acción mundial (world action model): predice a la vez cómo va a cambiar la escena y qué movimientos debe hacer el robot para lograrlo. Funciona en brazos con pinza, manos diestras de cinco dedos y humanoides.
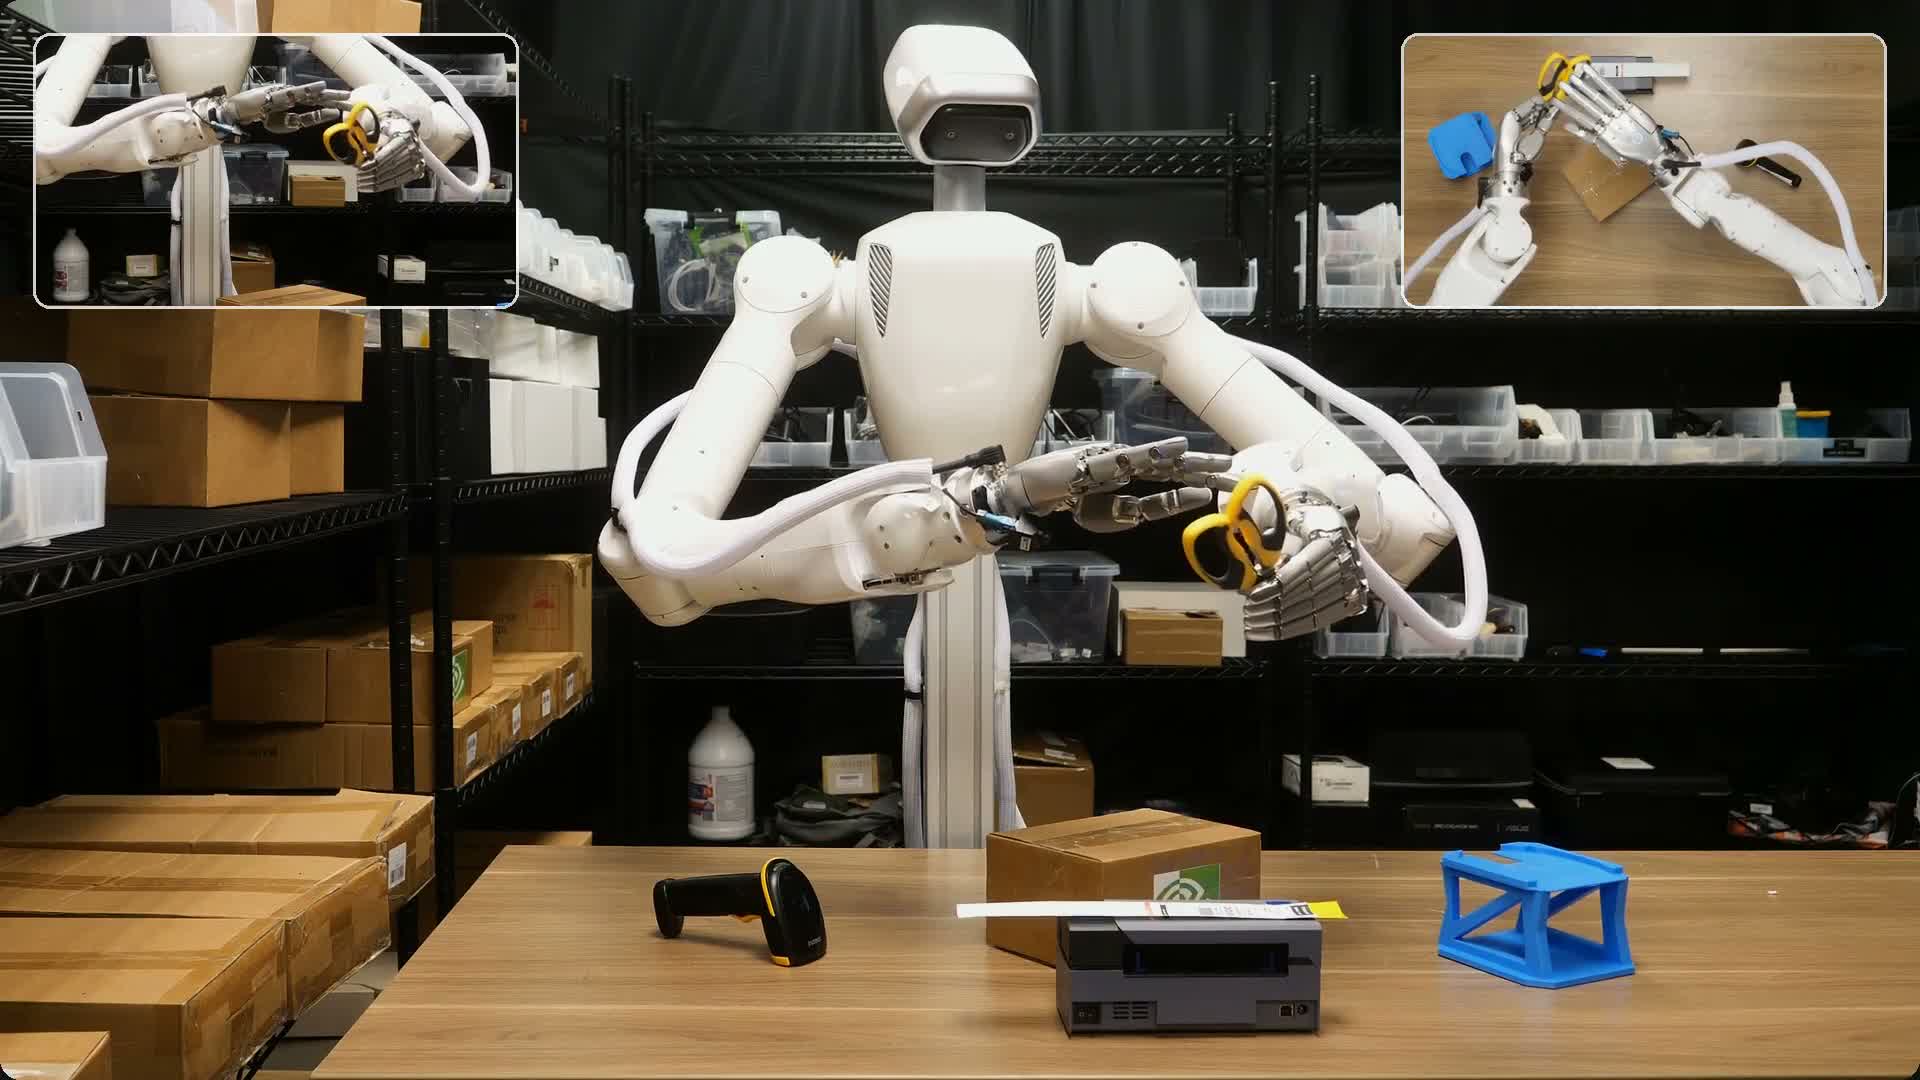
Aprende de humanos y lo traslada a cualquier cuerpo
La idea central es que el robot no necesita haber practicado la tarea: basta con que la haya visto hacer a una persona, o en otro robot. NVIDIA lo llama X-Adapt y lo demuestra en tres casos: un robot con dos manos de cinco dedos prepara un embudo de laboratorio con papel de filtro solo por haberlo visto en video humano, con un 65% de éxito; un brazo YAM arma un camión de juguete completo —una tarea de hasta 4 minutos— después de verlo solo con una pinza manual; y otro robot prepara yogur de banana con granola y hasta enciende una cerilla para prender una lámpara, aprendiendo de una mano wearable que imita sus dedos.
El entrenamiento mezcla 402,730 horas de video humano en primera persona, 10,184 horas de demostraciones con pinza manual en 2,897 tareas y 23,500 horas de teleoperación de robots. Y NVIDIA liberó 100,000 horas de ese video humano como el conjunto de datos Human-1M-100K, bajo licencia CC BY 4.0, que permite uso comercial y no comercial.
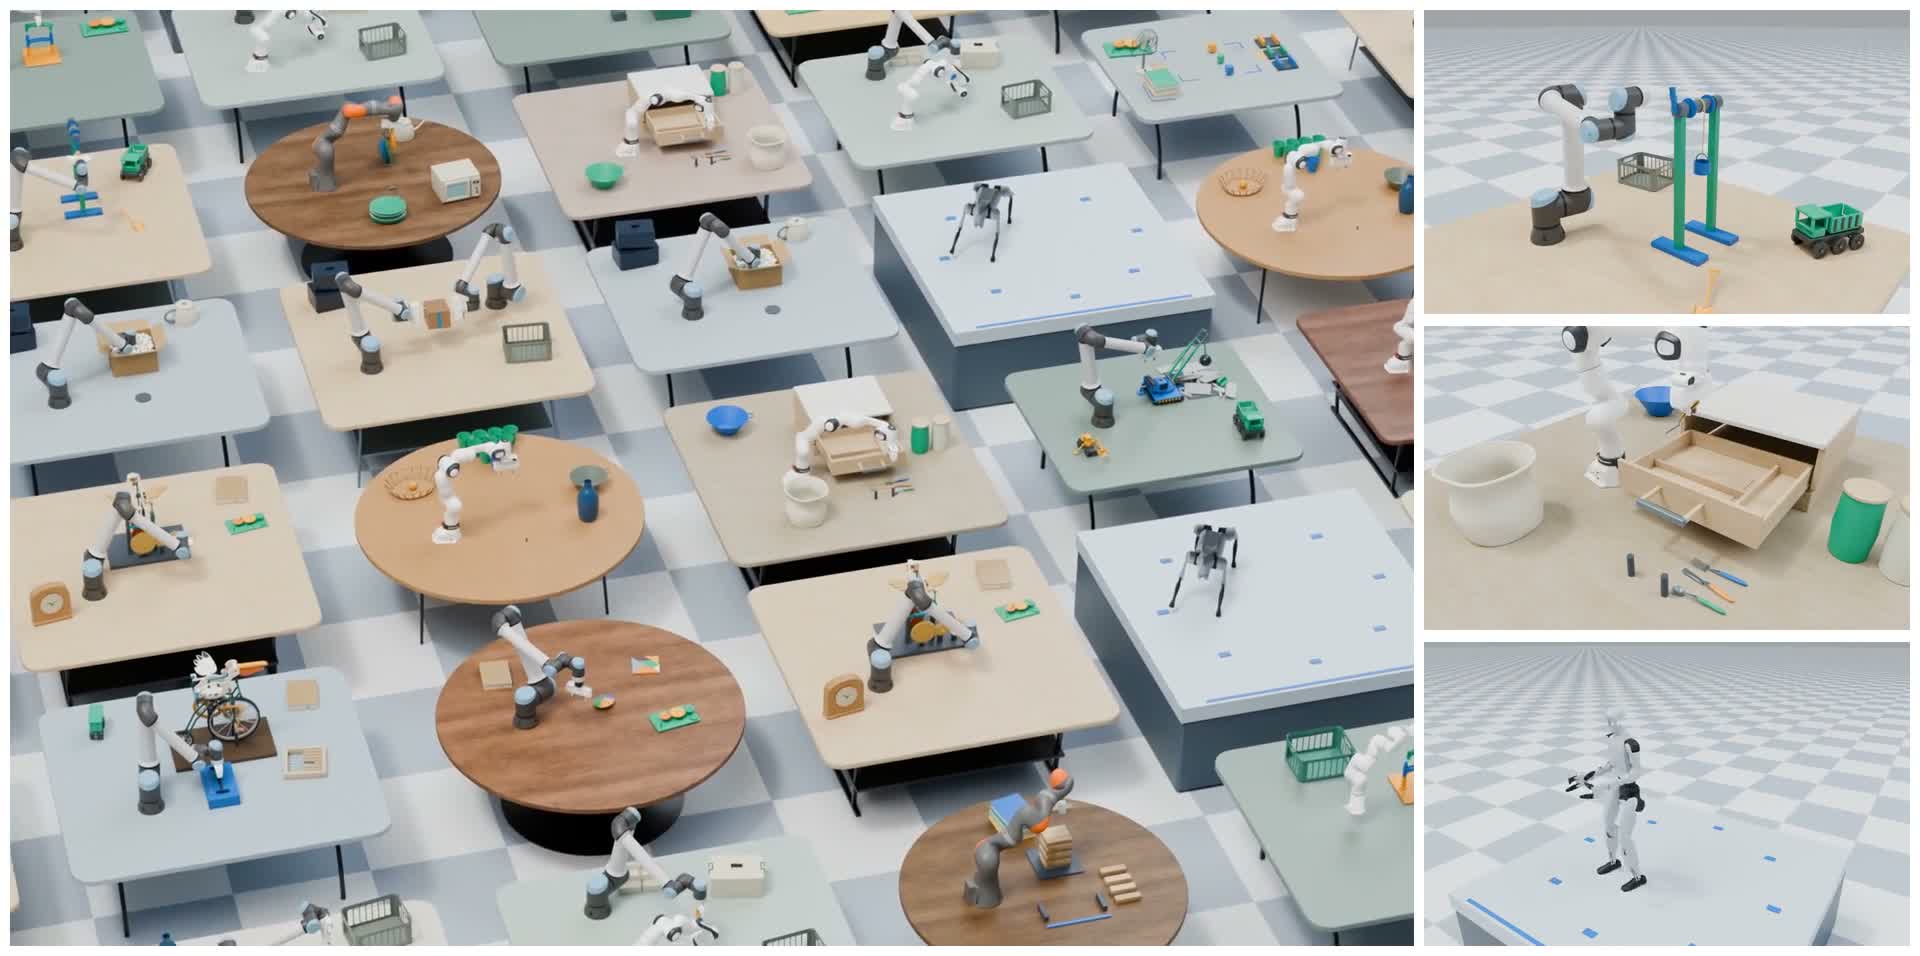
Los números: de 40% a 95% con cinco ejemplos
NVIDIA probó el modelo en 50 tareas que el robot evaluado nunca había practicado y que solo aparecían en video humano o en datos de otros robots. Sin ninguna demostración, completó al menos una vez 40 de las 50, con un 40% de éxito promedio. Con una demostración por tarea, sube a 71%, y con cinco, llega a 95%, con 37 de las 50 tareas saliendo bien en todos los intentos. La adaptación es barata: las cinco demostraciones suman menos de 3 minutos de datos de robot por tarea y el ajuste toma 30 minutos en una sola RTX 5090.
En destreza fina, el modelo coloca módulos de memoria GB300 con un 85% de éxito y arma el camión de juguete con un 65%. Y cuando un modelo de razonamiento lo dirige como herramienta, el robot ensambla juguetes en 97 o más de 100 intentos —98 de 100 aviones, 97 tractores y 97 autos—, recuperándose solo cuando se le cae una pieza.
El matiz del 95%
El 95% tiene una condición que el propio whitepaper de NVIDIA deja por escrito: las 50 tareas se eligieron entre aquellas que el modelo aprende con cinco episodios con al menos 80% de éxito. Es decir, el 95% mide lo que el modelo logra en tareas que ya se sabía que podía aprender así, no en cualquier tarea al azar. Y todas las cifras son de las propias pruebas de NVIDIA, sin verificación independiente publicada. Aun así, el salto es real: NVIDIA también lo ubica entre los tres mejores modelos en los benchmarks RoboCasa365, RoboLab, RoboDojo y MolmoSpaces.
GR00T 2 Turbo corre dentro del humanoide
Junto al modelo grande, NVIDIA presentó GR00T 2 Turbo, una variante más ligera —con un transformer de 2,000 millones de parámetros— que corre a bordo del humanoide Unitree G1. Cada predicción toma 124 milisegundos en el Jetson Thor del propio robot, y con ella el G1 sirve palomitas en los 48 intentos y limpia una mesa de objetos diversos en el 93% de los casos, moviendo todo el cuerpo mientras mantiene el equilibrio.
Quién ya lo está probando
Por ahora es investigación, no un producto en venta, pero ya hay empresas probándolo: Foxconn lo aplica a la automatización de la fabricación de servidores, Siemens lo evalúa en casos industriales y Nexuni lo prueba doblando ropa. También llegó Isaac Lab 3.0, la nueva versión del marco de entrenamiento de robots de NVIDIA, que en una prueba de manipulación diestra logra hasta 2.5 veces más rendimiento que la versión 2.3, además de dos nuevos benchmarks de evaluación, DexBench y VABAR.
Hay un “pero” para quien quiera probarlo ya: NVIDIA lo presenta como un modelo abierto, pero el código todavía no se puede descargar. Según la cobertura del anuncio, su página de investigación indica que el código llegará en diciembre, y aún no hay fecha pública para los pesos ni licencia anunciada. Lo que sí está abierto hoy es el conjunto de 100,000 horas de video humano.
¿Qué tarea de tu casa le enseñarías primero a un robot si bastara con mostrarle un video? Cuéntanos en los comentarios.