
Google acaba de ampliar su familia de chips de inteligencia artificial. Este 9 de noviembre de 2026 la compañía anunció dos nuevos sistemas de su octava generación de TPU (sus procesadores diseñados a medida para IA): el TPU 8tx, pensado para inferencia segura y confidencial, y el TPU 8i Max, creado para manejar ventanas de contexto enormes. Según Google, es la primera vez que presenta cuatro sistemas TPU en un mismo año.
Puntos clave
- Los TPU 8tx y 8i Max se suman a los TPU 8t (entrenamiento) y 8i (razonamiento en tiempo real) presentados en Google Cloud Next en abril.
- El TPU 8tx protege los datos y los pesos del modelo con seguridad integrada en el hardware, incluso mientras se procesan.
- El TPU 8i Max une dos chips TPU 8i en un solo paquete: el doble de cómputo, el doble de SRAM y el doble de ancho de banda HBM que el TPU 8i.
- Google también impulsa el acceso para desarrolladores con soporte para PyTorch y nuevas herramientas de código abierto.
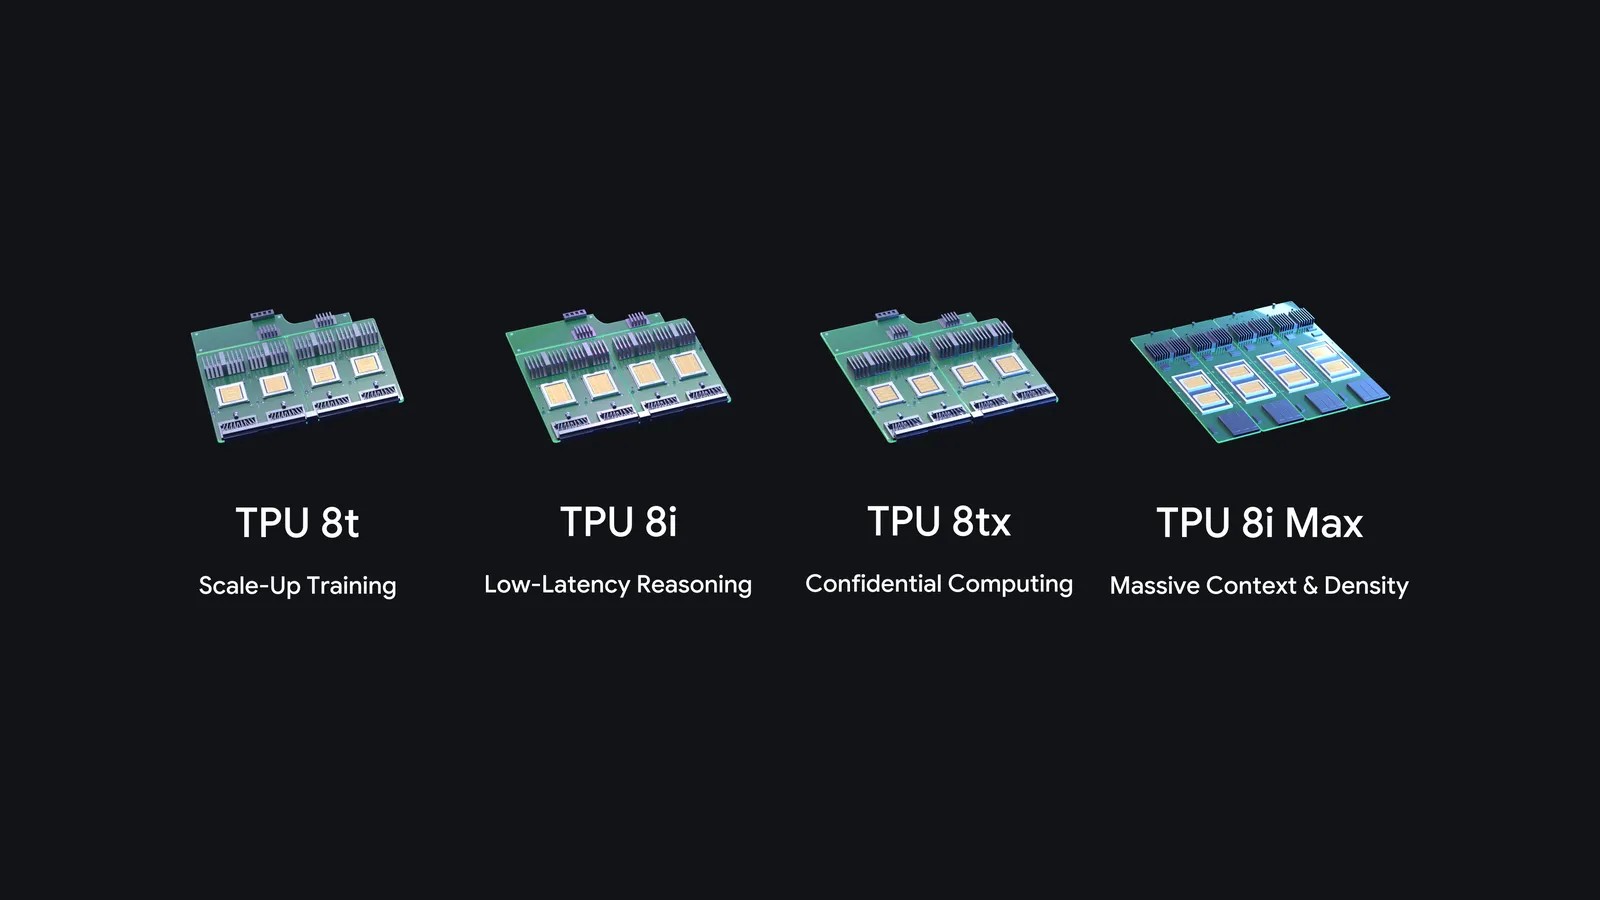
La octava generación de TPU de Google: TPU 8t, TPU 8i, TPU 8tx y TPU 8i Max. Imagen: Google.
TPU 8tx: IA confidencial para empresas y gobiernos
El TPU 8tx está optimizado para inferencia segura y confidencial, y según Google también sirve para entrenamiento a pequeña escala. Está dirigido a empresas reguladas y gobiernos que ejecutan modelos propios o de frontera y agentes autónomos junto a sus datos más sensibles.
Normalmente los datos están cifrados cuando se guardan o se envían por la red, pero deben descifrarse en memoria para procesarlos. El TPU 8tx usa el mismo silicio que el TPU 8t, va acompañado de CPUs AMD EPYC de 5.ª generación como anfitrión e integra la seguridad directamente en el hardware, de modo que los datos y los pesos del modelo siguen protegidos y aislados incluso mientras se usan.
Además adopta la red de baja latencia Boardfly, la misma creada para razonamiento en tiempo real. Google asegura que ofrece hasta 2 veces menos latencia que el TPU 8t con una penalización de rendimiento casi nula. También permite afinar modelos con datos privados, destilar modelos grandes en otros más pequeños y entrenar agentes con aprendizaje por refuerzo sin mover datos sensibles entre clústeres.
TPU 8i Max: el doble de todo para romper el “muro de memoria”
Cuando decenas de agentes de IA trabajan a la vez sobre todo el código de un proyecto o sobre horas de video, el ancho de banda de memoria se convierte en el cuello de botella. Para resolverlo, Google combinó dos chips TPU 8i en un solo paquete.
- Cómputo: el doble que el TPU 8i.
- SRAM: el doble que el TPU 8i.
- Ancho de banda HBM: el doble que el TPU 8i.
- Densidad: cabe el doble de silicio en el mismo espacio de rack, con más potencia por metro cuadrado y por vatio.
Así queda la octava generación de TPU
- TPU 8t: entrenamiento a gran escala.
- TPU 8i: razonamiento de baja latencia.
- TPU 8tx: computación confidencial.
- TPU 8i Max: ventanas de contexto masivas y máxima densidad de cómputo por rack.
Como referencia, Google recuerda que los TPU 8t y 8i ofrecen hasta 2.7 veces mejor rendimiento de entrenamiento y 80% mejor relación precio-rendimiento en inferencia, respectivamente, frente a la generación anterior. La compañía añade que el negocio de TPU ya tiene casi 100 clientes, entre laboratorios de IA, firmas financieras, minoristas y universidades.
Más fácil para los desarrolladores
- TorchTPU: el código de PyTorch y los modelos de Hugging Face corren de forma nativa en TPU, con soporte para motores como vLLM y SGLang.
- Suite de agentes para TPU (en vista previa): se conecta con herramientas como Claude Code, Cursor y Google Antigravity para automatizar la puesta en marcha y optimizar kernels con lenguaje natural.
- Agent Compute Engine: suspende sesiones de agentes inactivas y mueve su memoria fuera del chip en milisegundos para ahorrar costos.
- TPU Sync (código abierto): une la memoria del chip, la RAM del servidor, el almacenamiento y la red en una sola jerarquía; Google dice que reduce más de 90% la latencia de transferencia de caché KV y el tiempo hasta el primer token.
- Cloud Pathways y GKE dynamic slicing: ya disponibles de forma general en Google Kubernetes Engine.
Precio y disponibilidad
Google no ha publicado precios ni una fecha concreta de disponibilidad para los TPU 8tx y 8i Max en su anuncio. Se trata de sistemas para centros de datos y clientes de Google Cloud, no de productos de consumo. Actualizaremos cuando la compañía comparta más detalles.
Fuente oficial: Google Blog: Our newest TPUs: 8tx and 8i Max, built for the agentic era